Что я проверяю между прототипом и рабочей системой
Прототип может отвечать правильно и всё ещё быть неготовым к ежедневной работе. Разбираю источники, сбои, поддержку, стоимость и возвращение к прежнему процессу.
Обновлено
Работающий прототип — важный результат. Он показывает, что выбранный подход способен решить задачу в определённых условиях. Но после демонстрации я хочу отдельно обсудить, что потребуется для ежедневной работы.
В реальном процессе меняются документы, сотрудники задают неполные вопросы, источники иногда недоступны, а результат нужен в конкретный срок. У системы появляются пользователи, ответственность и стоимость сопровождения.
Поэтому между «получилось показать» и «можно включать в работу» я оставляю отдельный этап проверки.
Сначала уточняю, что доказал прототип
Полезно записать условия демонстрации: какие данные использовались, кто готовил запросы, какие действия выполнялись вручную и что осталось за пределами проверки.
Допустим, помощник успешно ответил по заранее выбранным документам. Это подтверждает работу на этой выборке. Пока неизвестно, как он поведёт себя с новыми файлами, конфликтующими версиями и вопросами без ответа.
Мне важно сохранить ценность результата и одновременно не расширять его смысл. Если один человек вручную подготовил данные перед показом, эта подготовка тоже должна войти в будущий процесс или быть заменена проверяемым механизмом.
Проверяю путь обновления данных
Система может правильно отвечать сегодня и использовать устаревшие сведения завтра. Поэтому в рабочей версии нужен определённый порядок обновления.
Кто меняет источник? Когда новая версия становится доступна? Как удалить ошибочную? Как понять, по какой версии подготовлен ответ?
Особенно важно проверить частичное обновление. Например, новый прайс уже загружен, а связанные условия ещё старые. Для бизнеса это может выглядеть как один правильный ответ, составленный из несовместимых частей.
До запуска я хочу увидеть не только первый импорт, но и повторное обновление, ошибку обновления и восстановление после неё.
Проигрываю обычные сбои
Полезно заранее договориться о поведении при недоступном источнике, долгом ответе модели и ошибке сохранения результата.
В учебном сценарии подготовки документа возможен такой порядок: показать текущий статус, не обещать завершение без подтверждения, сохранить задачу для повторной проверки и дать сотруднику способ продолжить вручную.
Мне не нужен одинаковый механизм для всех сбоев. Для временно недоступного справочника может подойти ожидание. Для противоречивых данных нужна проверка человеком. Для неопределённого результата внешнего действия сначала следует установить, что уже произошло.
Чем раньше эти различия описаны, тем меньше неожиданных решений придётся принимать во время реального инцидента.
Проверяю наблюдаемость для разных людей
Разработчику нужны технические подробности. Сотруднику — понятный статус своей задачи. Руководителю — влияние на работу и решение о продолжении.
Поэтому один общий экран с надписью «ошибка» не подходит всем. Я хочу, чтобы команда могла ответить: сколько задач затронуто, какие из них требуют ручной обработки, что уже восстановлено и кто отвечает за следующий шаг.
При этом нельзя собирать всё подряд. Объём журналов, доступ к ним и сроки хранения должны соответствовать задаче и правилам компании. Для диагностики полезнее необходимые факты, чем бесконечная копия переписки.
Считаю стоимость регулярной работы
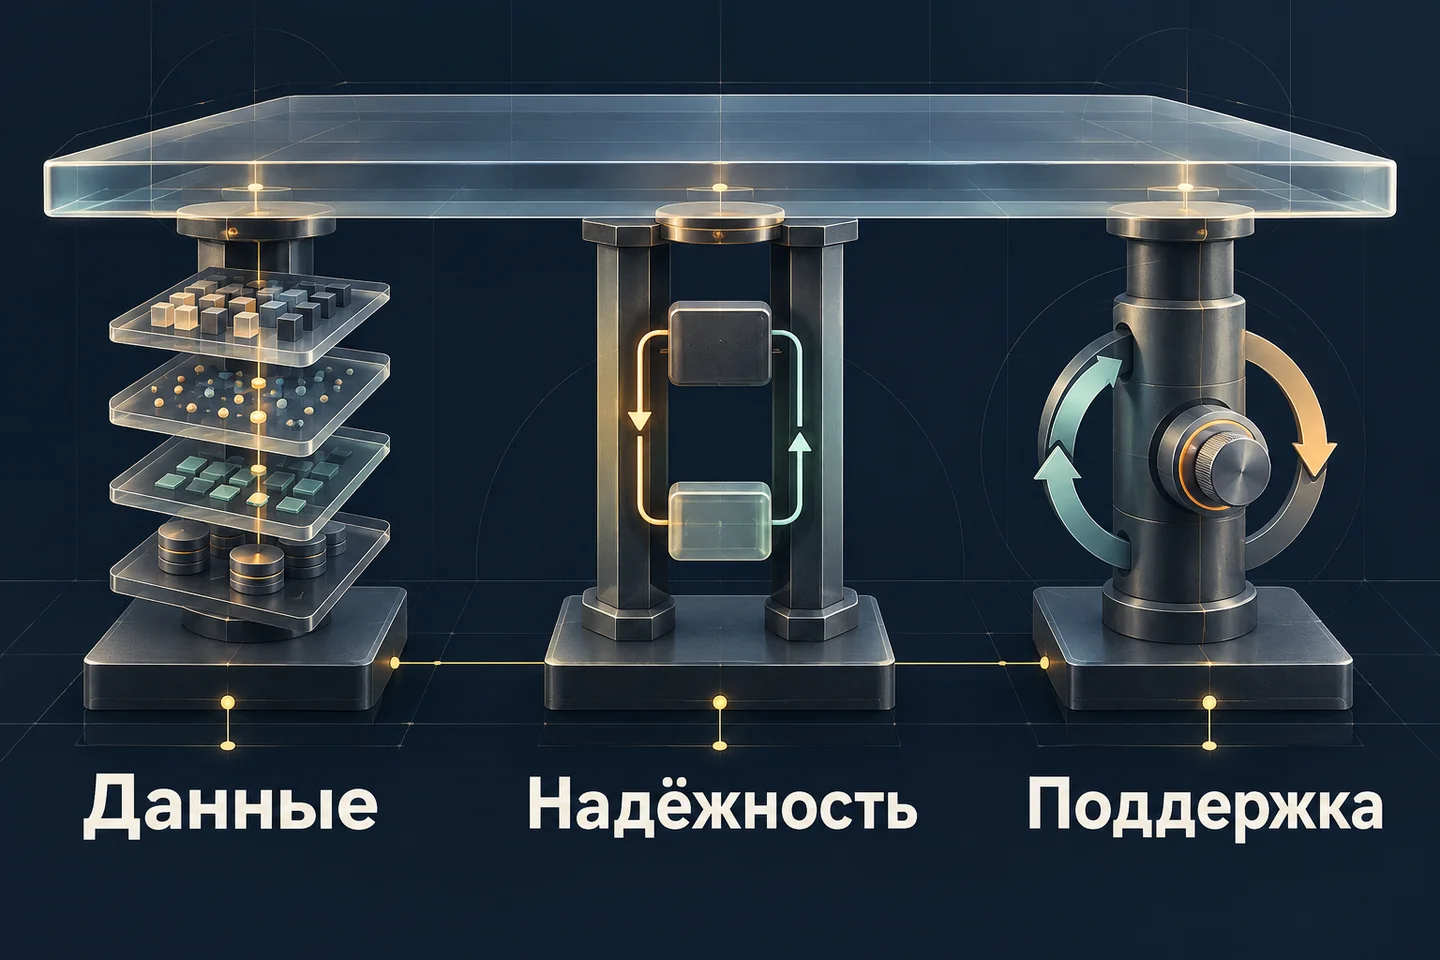
Цена создания прототипа не описывает стоимость его использования. В расчёт входят работа сервисов, хранение и обработка данных, сопровождение интеграций, контроль качества и время сотрудников.
Я предпочитаю смотреть на стоимость завершённой операции. Если система часто требует повторного прогона и ручного исправления, стоимость одного обращения может оказаться выше ожиданий по тарифу модели.
Сначала достаточно прозрачного расчёта с допущениями. После ограниченного запуска его нужно заменить наблюдениями. Мне важно, чтобы команда могла объяснить, какие части оценки уже измерены, а какие ещё являются гипотезой.
Назначаю владельцев и проверяю возврат
У рабочей системы должен быть ответственный со стороны бизнеса и понятный порядок поддержки. Кто решает, что поведение неправильное? Кто может остановить автоматические действия? Кто меняет правило и принимает исправление?
Отдельно нужен способ вернуться к предыдущей рабочей версии или продолжить процесс вручную. Возможность возврата следует проверить до выпуска, а не впервые искать её после сбоя.
Для системы с внешними действиями важно понимать и пределы возврата. Отключение новой версии не отменит уже отправленное письмо. Такие последствия требуют отдельного разбора.
Как выглядит решение о запуске
Я предлагаю закончить подготовку коротким документом: область использования, известные ограничения, критерии качества, права системы, ответственные, порядок остановки и первые показатели наблюдения.
Начальный запуск можно ограничить группой сотрудников или типом задач. Так проще сравнить ожидания с реальной работой и вовремя уточнить границы.
Для меня переход в эксплуатацию завершён, когда система полезна не только рядом с автором прототипа. Другой сотрудник должен понимать, как ей пользоваться, куда обращаться при проблеме и что делать, если она недоступна. Именно эту самостоятельность процесса я хочу увидеть до расширения внедрения.